Zwei Zugangswege. Zweimal keine Verbindung.
Dienstagmorgen: Die Banking-App lässt keine Anmeldung zu. Also ab zum Webportal. Dort geht ebenfalls nichts. Zwei Benutzeroberflächen, zwei Fehlermeldungen – das ist zumindest bemerkenswert synchronisiert.
Am 20. Oktober 2026 meldeten Kunden der ING Deutschland Probleme beim Kontozugriff über App und Internetbanking. Nach den veröffentlichten Berichten bestätigte das Institut technische Schwierigkeiten; auch die telefonische Erreichbarkeit war eingeschränkt. Über die genaue Ursache lagen zunächst keine belastbaren technischen Details vor.
Die entscheidende Frage lautet nicht, ob zwei Anwendungen existieren, sondern ob sie unabhängige Fehlerdomänen besitzen. Die ironische Überschrift behauptet ausdrücklich nicht, dass bei ING zwei tatsächlich redundante Systeme versagt haben. Die Architektur der betroffenen Bank ist öffentlich nicht ausreichend dokumentiert.
Drei aktuelle Beobachtungen, nicht eine gemeinsame Ursache
ING: Login gestört, nicht zwangsläufig jeder Zahlungsweg
Nach den Berichten vom 20. Oktober waren App und Internetbanking betroffen. Zugleich sollten Karten- und Bargeldfunktionen grundsätzlich weiter nutzbar sein. Ein Login-Ausfall bedeutet deshalb nicht automatisch einen Ausfall sämtlicher Bankdienstleistungen. Ein bankinternes Konto-Backend, das Kartennetz und die Online-Oberfläche können unterschiedliche Betriebswege besitzen.
Die Bank nannte zunächst keine konkrete technische Ursache. Ein Cyberangriff oder ein bestimmter Cloud-Dienst als Auslöser ist deshalb nicht belegt. Auch lässt sich aus dem Fehlerbild nicht schließen, dass beide Oberflächen dieselbe Authentifizierung oder Datenbank verwenden.
Revolut: Gleichzeitige Einschränkungen mit gesonderter Einordnung
Am selben Tag waren auch Dienste von Revolut beeinträchtigt. Berichte und Aussagen des Unternehmens ordneten die Einschränkungen einem Google-Cloud-Vorfall zu. Dies ist eine andere Evidenzlage als bei ING: Eine bestätigte Abhängigkeit bei Revolut darf nicht auf einen anderen Anbieter übertragen werden.
Google Cloud: Dokumentierte regionale Infrastrukturstörung
Die Statusseite von Google Cloud dokumentierte seit dem 19. Oktober, 23:08 Uhr US/Pacific, Probleme in der Londoner Region europe-west2 – in Deutschland bereits am Morgen des 20. Oktober. Betroffene Dienste meldeten erhöhte Fehlerraten und zeitweise Netzwerkprobleme.
Die über mehrere Anwendungen sichtbare Wirkung illustriert reale Konzentrationsrisiken. Es ist aber kein Nachweis, dass die ING-Probleme über denselben Fehlerpfad entstanden. Zeitgleiche Meldungen, identische Symptome und derselbe Markt reichen für eine technische Ursachenbestimmung nicht aus.
Der Erkenntnisgewinn dieser Fälle liegt im Vergleich: Bei ING ist primär das äußere Fehlerbild dokumentiert, bei Revolut existiert eine berichtete Provider-Zuordnung, und bei Google Cloud ein eigener technischer Incident-Verlauf. Das sind verschiedene Nachweisebenen.
Zwei Frontends sind noch keine unabhängigen Systeme
Eine App und eine Webseite können vollständig unterschiedliche Oberflächen haben und trotzdem denselben Identity-Provider, dasselbe API-Gateway oder denselben Kontoservice benötigen. Fällt eine gemeinsame Komponente aus, kann sich der Fehler auf beide Kanäle ausbreiten.
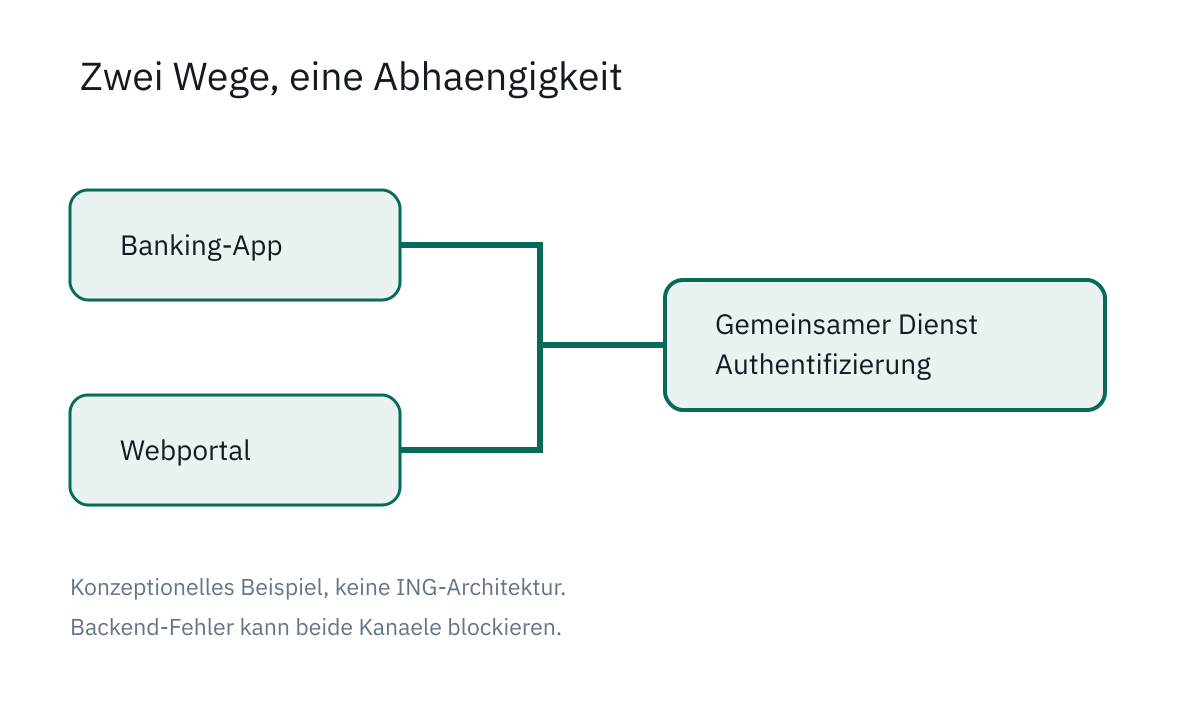
Das Diagramm zeigt ausschließlich einen konzeptionellen möglichen Aufbau, nicht die reale Bankarchitektur. Gerade dieser Unterschied ist wichtig: Beobachtete Gleichzeitigkeit liefert eine Hypothese über gemeinsame Abhängigkeiten, aber keine bestätigte Root Cause Analysis.
Ein HTTP-Status 200 OK für eine Startseite sagt ohnehin wenig darüber aus, ob die Authentifizierung funktioniert, ein Token ausgegeben wird und der Kontoservice anschließend konsistente Daten liefert.
Redundanz bedeutet mehrfach vorhandene Komponenten. Resilienz verlangt zusätzlich, dass die Alternativen nicht an derselben Fehlerquelle hängen.
Warum ein zweites Rechenzentrum nicht automatisch hilft
Zwei Server helfen gegen den Ausfall eines einzelnen Servers. Zwei Availability Zones können bestimmte lokale Infrastrukturfehler abfangen. Eine zweite Cloud-Region schützt gegen manche regionalen Störungen.
Bei einer identischen Fehlkonfiguration, einer zentralen Anmeldung oder einem globalen Deployment können dennoch beide Seiten gleichzeitig beeinträchtigt sein. Für echte Unabhängigkeit müssen Datenpfade, DNS, Zertifikate, Zugänge, Deployments und externe Schnittstellen in die Bewertung einfließen.
Gerade bei Banken hat ein Failover weitere Voraussetzungen: Bestätigte Überweisungen dürfen weder verloren gehen noch doppelt verbucht werden. Eine technisch schnelle Umschaltung ohne konsistenten Transaktionszustand wäre kein zuverlässiger Wiederanlauf. Idempotente Verarbeitung, Zustandsabgleich und nachvollziehbare Bestätigungen sind wesentlicher als ein bloß grün angezeigter Ersatzserver.
Eine Multi-Region-Architektur kann zudem Komplexität und neue Fehlermöglichkeiten einführen. Deshalb muss dokumentiert sein, welches Szenario durch die Redundanz abgedeckt wird – und welches nicht.
Wenn das Dashboard grün ist und der Login rot
Traditionelle Infrastrukturüberwachung prüft Prozesslaufzeiten, Antwortzeiten, CPU, Datenbanken oder Erreichbarkeit. Diese Werte sind notwendig, aber keine Garantie für erfolgreiche End-to-End-Geschäftsprozesse.
Ein funktionierendes Gateway kann jeden Anmeldeversuch an einen gestörten Authentifizierungsdienst weiterleiten. Aus Sicht der Plattform antwortet ein Server, aus Sicht der Nutzer funktioniert das Banking nicht.
Synthetische Transaktionen sind eine Möglichkeit, diese Lücke zu schließen. Dazu dienen kontrollierte Testkonten und definierte, sichere Abläufe, die Login, Tokenvalidierung und eine unkritische Testfunktion erfassen. Produktive Überweisungen sollten dafür nicht unkoordiniert ausgelöst werden.
Mit Distributed Tracing, korrelierten Log-IDs und Fehlerraten je Dienst lässt sich zusätzlich analysieren, wo eine Anfrage scheitert: im Client, beim Gateway, im Identity-Dienst, bei einer nachgelagerten API oder in einem externen Abhängigkeitsdienst.
Besonders hilfreich ist eine aktuelle Abhängigkeitsübersicht: Welche Teams, Anwendungen und Geschäftsprozesse nutzen dieselben Komponenten? Erst daraus entstehen belastbare Hypothesen über gemeinsame Fehlerdomänen.
DORA: Betriebssicherheit lässt sich nicht herbeizertifizieren
Für betroffene Finanzunternehmen schafft der Digital Operational Resilience Act (DORA) einen europäischen Rahmen für IKT-Risikomanagement, Resilienztests, Vorfallbehandlung und Dienstleisterrisiken. Zentral ist die Frage, wie kritische oder wichtige Funktionen auch bei technischen Störungen beherrschbar bleiben.
Die europäischen Aufsichtsbehörden haben 2026 erste Auswertungen schwerwiegender IKT-Vorfälle veröffentlicht. Sie verdeutlichen, warum Abhängigkeiten und Vorfallklassifizierung nicht nur lokale Betriebsaufgaben sind.
Nicht jeder Login-Fehler ist deshalb automatisch ein meldepflichtiger DORA-Vorfall. Die Bewertung hängt von regulatorischen Kriterien wie Auswirkung und Umfang ab. Aus öffentlich berichteten Störungen lässt sich weder eine Pflichtverletzung noch die vollständige Klassifikation eines konkreten Falls ableiten.
Fünf Prüfungen für IT-Verantwortliche
1. Geschäftsprozesse inventarisieren. Nicht allein Server auflisten, sondern die technischen Abhängigkeiten von Anmeldung, Buchung und anderen kritischen Vorgängen dokumentieren.
2. Gemeinsame Fehlerdomänen finden. Prüfen, ob alternative Zugänge denselben Identity-Provider, dieselbe Datenbank, dasselbe Routing oder dieselben externen Dienste brauchen.
3. Failover praktisch testen. Ein Notfallplan ersetzt keinen beobachteten Umschaltversuch. Tests müssen Fehlerfälle und Datenkonsistenz einschließlich bereits bestätigter Transaktionen abdecken.
4. End-to-End-Verfügbarkeit messen. Erfolgreiche Geschäftsprozesse überwachen und von bloßer Infrastruktur-Erreichbarkeit unterscheiden. Dazu gehören echte Fehlerraten, kontrollierte synthetische Tests und aussagekräftige Traces.
5. Wiederherstellungsziele festlegen. RTO und RPO müssen aus dem Geschäftsbedarf abgeleitet werden. Bei transaktionalen Anwendungen zählt neben der Wiederanlaufzeit der belegbare Zustand jeder bestätigten Buchung.
Fazit: Zweimal vorhanden ist noch nicht zweimal unabhängig
Die ING-Störung vom 20. Oktober 2026 macht das Problem fehlender digitaler Zugänglichkeit anschaulich. Revolut und der dokumentierte Google-Cloud-Vorfall zeigen weitere, voneinander sauber zu unterscheidende Störungs- und Abhängigkeitsbilder. Eine gemeinsame technische Ursache aller drei Fälle ist nicht nachgewiesen.
Die eigentliche Architekturfrage bleibt: Welcher Geschäftsprozess funktioniert noch, wenn eine vermeintlich redundante Infrastruktur ihre gemeinsame Voraussetzung verliert?
Eine alternative Oberfläche ist nicht automatisch ein alternativer Fehlerpfad. Und zwei gemeinsam ausgefallene Systeme sind vor allem eines: sehr gut synchronisiert.
Quellen und Kenntnisstand
Stand: 20. Oktober 2026. Laufende Ursachenanalysen und Wiederherstellungsangaben können sich ändern.
- heise online: ING-Bank-Kunden haben keinen Zugriff auf ihre Konten – Ausgangsbericht über die Zugangsprobleme.
- Google Cloud: Incident europe-west2 – Original-Statusdokumentation der regionalen Störung.
- Associated Press, 20.10.2026 – Bericht zu betroffenen Banken und Revolut-Stellungnahme.
- EBA: Bericht zu schwerwiegenden IKT-Vorfällen, Juni 2026 – regulatorischer Hintergrund.
Methodische Grenze: Die skizzierten Backend-Abhängigkeiten sind ein technisches Modell und keine Rekonstruktion des konkreten ING-Ausfalls. Die berichteten Einschränkungen bei Revolut und Google Cloud dürfen nicht ohne Belege mit der ING-Störung gleichgesetzt werden.
Von der Einordnung zur Umsetzung
Was bedeutet das für Ihre IT?
Ich unterstütze Sie dabei, Ihre Ausgangslage zu prüfen und passende Maßnahmen in einem abgestimmten Projektumfang zu planen.
Vorhaben besprechen